


인기기사
- 1 내년 초등학교 입학생 사상 처음 20만 명대 전망 : 2020년 출생아 27만 명으로 2019년보다 3만 명 적어
- 2 이재명 장남, 국힘 주진우 명예훼손 혐의로 고소했다 : 역대 '의원 명예훼손 사건'의 결말은?
- 3 트럼프가 원하던 '노벨평화상' 대한민국 국민에게? : 1996년 노벨상 수상한 동티모르 대통령 '빛의 혁명' 적극 추천
- 4 "아파트 공동명의 했으면 좋겠다" 이 한 마디에 4년 된 커플 파혼 위기 : 상견례 때 말조심, 남녀별 1위는?
- 5 삼성전자 주가 얼마나 떨어졌으면 삼성 라이온즈 우승 기념 할인이란 얘기가? 증권사들은 그래도 '실적'에 기대 건다
- 6 '현백코어'를 아시나요, 요즘 2030세대 이를 선망하는 이유 : 명품보다 탐나는 '부자의 여유'
- 7 '독서 소멸' 시대에 KT밀리의서재 매출 올해 1천억 넘본다 : 통신 3사 제휴 통한 '성공' 발판으로 오리지널 IP 확보 강화
- 8 일론 머스크의 심대한 패착 : '난공불락' 꿈꾸며 공화당 텃밭 텍사스로 거점 옮겼는데, 중간선거 후 사방에 '적'이다
- 9 LS전선에 '인사'로 힘 실어준 LS그룹 : 대표 구본규 부회장 승진하며 대한전선과 'HVDC 해저케이블' 결전 벌인다
- 10 배우 김수현 11일 가로세로연구소 김세의 형사재판에 증인으로 출석한다 : 김새론 교제와 채무 변제 압박 '진실은 어디까지'

최신기사
-
 씨저널&경제 SK케미칼 3분기 실적 자회사와 스페셜티 소재로 버텼다 : 별도 영업이익 164억 45% 줄었지만 연결기준은 2 배 넘게 늘었다
고부가제품 확대가 주요 전략
-
 씨저널&경제 LG 'K-엑사원 2.5'가 중국 대표 AI 딥시크 넘었다 : 자체 평가서 AI 에이전트 성능 4개 지표 중 3개 앞서
개발자 피드백 기다린다
-
 씨저널&경제 LG유플러스 AI 데이터센터 매출 올해 세 분기 연속 25% 넘게 성장, 홍범식 내년 투자 확대로 현금흐름 확보 능력 시험대
파주 AIDC 일정 2년 앞당겼다
-
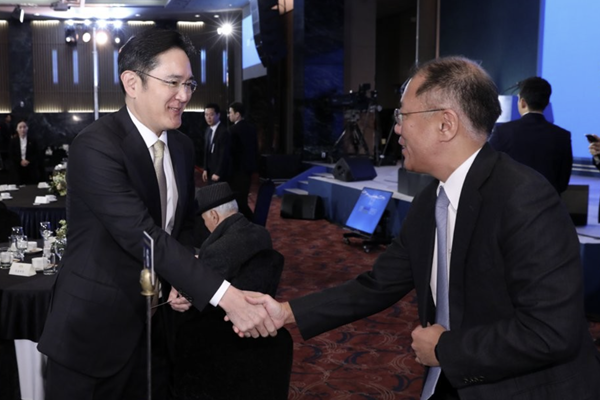 씨저널&경제 41년 전 이병철·정주영, 25년 전 이건희·정몽구 회동 그리고 2026년 : 삼성전자가 현대차 경영진 초청해 '3대째 인연' 강조했다
미래 모빌리티 협력에서 시너지 낼까
-
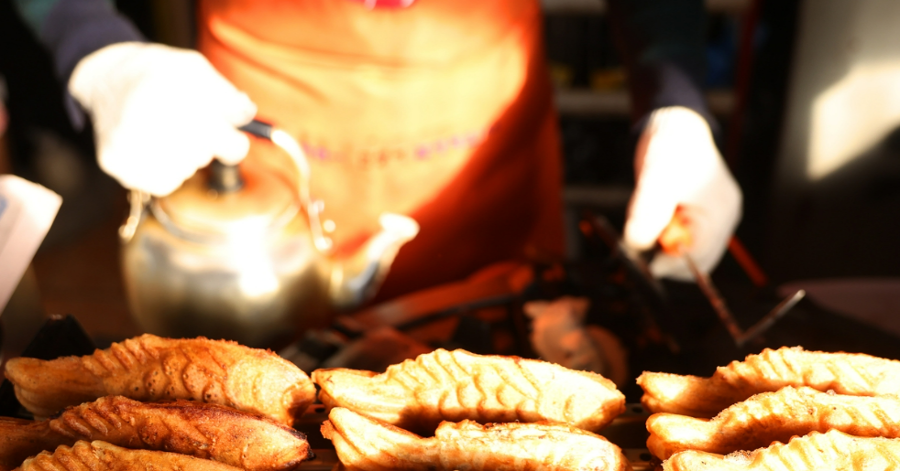 뉴스&이슈 법원, 무허가 붕어빵 노점상에 '50만 원 벌금형' 집행유예 : "하루 3만 원 벌이로 성실하게 사는 사람"
따뜻한 눈길, '제도의 문제' 살폈다
-
 뉴스&이슈 '피부과' 간판 보고 들어갔는데 진료는 안 한다고? : '진료과목 피부과' 내건 서울 병원 중 88% 전문의 없어
민주당 박지원 '의료법 개정안' 발의
-
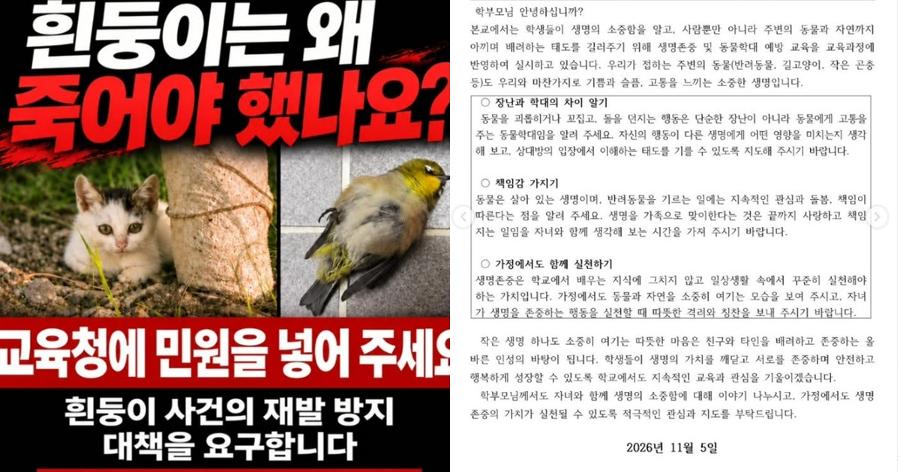 라이프 "흰둥이는 왜 죽어야 했나요?" 김해 A초등학교 인근 연쇄 동물학대 의혹 : '생명존중교육' 가정통신문도 나왔다
놀란 아이들, 따로 돌봐야
-
 씨저널&경제 대웅제약 4분기 이후 실적 절벽 가능성 : 이창재·박성수 위식도역류 약 직판 안착과 보툴리눔 톡신 출하 공백 회복 속도 낸다
증권사들 줄줄이 목표주가 하향
-
 글로벌 엔비디아 젠슨 황에게 닥칠지 모를 '3가지 미래' : '앨리스 황 사태' 이후 기소, 사임 또는 해임, 이혼이 야기할 문제들
국가 기밀 유출 처벌, 승계, 이혼
-
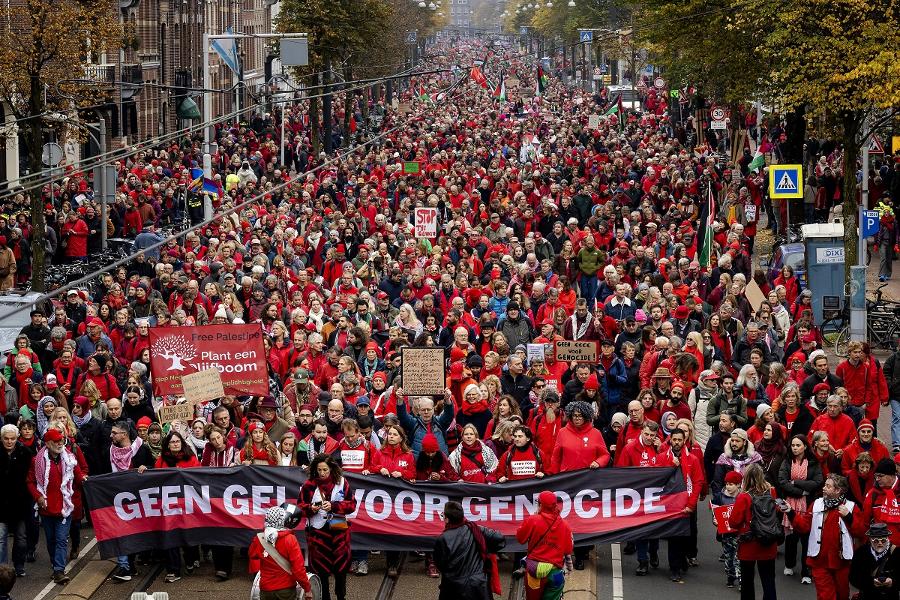 글로벌 암스테르담의 붉은 물결, 수만 명이 '레드 라인'에 모였다 : 붉은 옷은 저항과 연대 상징
"집단학살에 돈 대지 마라"