


인기기사
- 1 이규석 현대모비스 램프 사업 6천억 '헐값 매각' 추진에 '지배구조 개편' 논란 재현, 11월 주총까지 매각가격 근거 설득 절실
- 2 국힘 장동혁이 양향자의 조직위원장 경선 전면 재선거 요구에 격분했다 : 당내 주도권 갈등으로 번지나
- 3 [KSOI] 이재명·민주당 지지율 나란히 34.9%로 추락 : 중수청장 인선 논란에 '집토끼' 이탈 심상찮다
- 4 스타 상어 부캉이가 부산 북항 친수공원 인공수로 머문 지 28일이다 : 황당 민원에 공무원들 '진땀'
- 5 가수 없는 'AI 창작곡'이 걸그룹 '리센느' 꺾고 멜론 차트 최상위권 차지했다 : AI로 만든 노래, 저작권료 받을 수 있을까?
- 6 민주당 김민석의 신천지 의혹 재점화에 박지원 "대통령 지지도 떨어져" 비판 : 반복되는 여권 내 갈등, 당대표 리더십 시험대
- 7 미국 50개 주 변호사 명부 다 뒤졌다 : 백악관 대변인의 '변호사 행세' 좌초시킨 한 독립언론 기자의 집요한 취재
- 8 대한전선 부회장 송종민 LS전선 아성에 균열 낸다 : 서해안 에너지 고속도로 사업 앞두고 해저케이블 생산·시공 역량 키우기 박차
- 9 아워홈 매각 뒤 구미현의 패션·뷰티사업 도전 녹녹치 않아 보이는 이유 : '2년 적자' 본느, '1% 미만 이익' 씨싸이트 복원은 험난하다
- 10 청와대 비서실장 임광현 출근 첫날 대통령 일성은 "비서실장 중심으로" : '김현지 대세설' 차단용 발언이란 분석도 나왔다

최신기사
-
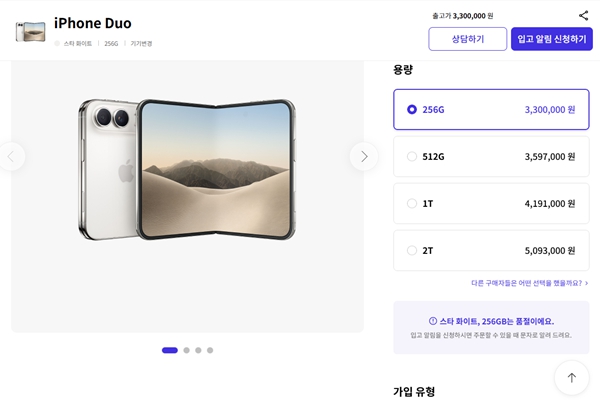 씨저널&경제 500만 원짜리 휴대폰 '아이폰 듀오' 놓고 SK텔레콤 KT LG유플러스 고객 확보전 뜨겁다 : 보상 프로그램 조건도 면밀하게 확인해야
'아이폰 듀오', 최소 330만 원부터 출발
-
 씨저널&경제 1차 모집 때 닷새 만에 완판됐던 국민참여성장펀드의 달라진 성적표 : 2차는 목표액 87%밖에 못채웠다
목표 달성률 86.6%
-
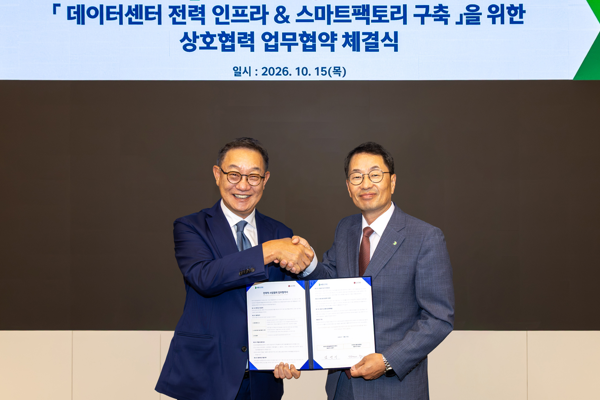 씨저널&경제 제조의 HD현대일렉트릭 IT의 LG CNS가 서로 경쟁력 합쳐서 전력 인프라 시장 잡는다 : 데이터센터·스마트 제조 협력 맞손
두 기업 대표 총출동
-
 씨저널&경제 구본욱 KB손보 사장, 테러·전쟁 다루는 '특수위험' 시장서 활로 모색하나 : 해외사업 부진 속 영국 '로이드 시장' 진출설 확산
로이즈는 80%대 합산비율로 안정적 수익을 내고 있다
-
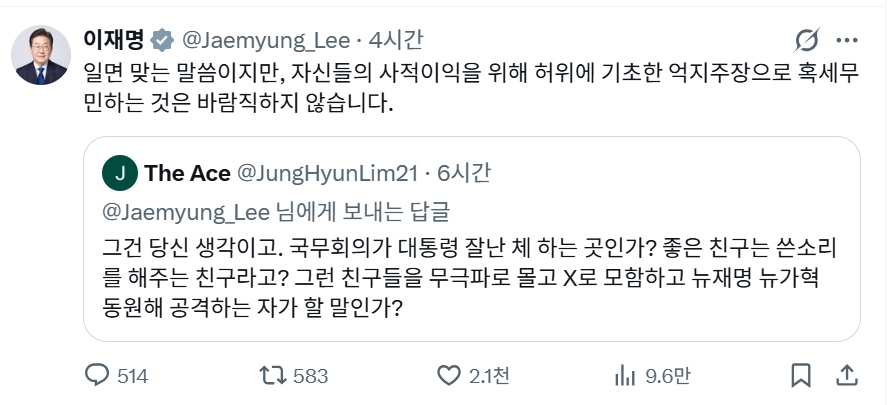 뉴스&이슈 이재명 대통령, 이틀 연속 일반 국민 SNS 글 직접 반박 : 소통인가, 공개 저격인가
비판 이용자 계정 탈퇴까지
-
 씨저널&경제 두산그룹 박정원·박지원 보좌할 전문경영인 부회장단 두터워진다 : 지주사 김민철, 에너빌리티 박상현 승진으로 CFO 역할 강화
두산그룹 사업 확장 국면에서 전문경영인 책임 커진다
-
 씨저널&경제 금호석유화학 오너 3세 박준경 경영 능력 평가대 올랐다 : 확장 나선 기존 사업 지지부진, 신사업은 이제 막 걸음마
추진 사업 전반에서 생산량·가동률 저조
-
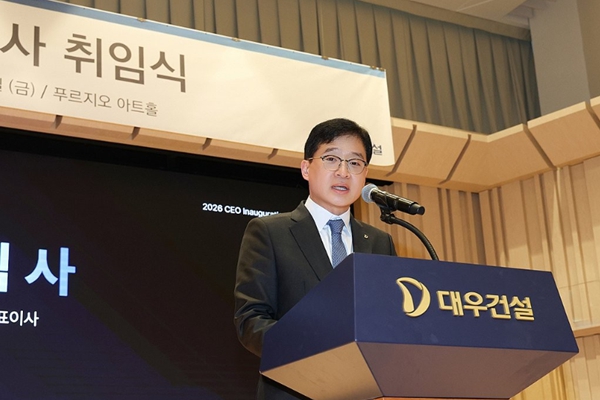 씨저널&경제 대우건설 대표 이강석 가덕도신공항 공사비 보장 두고 정부와 줄다리기, 특별법 개정 늦어지면 27조 수주도 빨간불
가덕도신공항 공사비 증액 약속 어떻게 받아낼까
-
 글로벌 영국 정부, '목 조르기'나 '근친상간' 묘사한 온라인 음란물 금지 나선다 : 왜곡된 성 인식 예방 위한 조치
오는 11월6일부터 불법
-
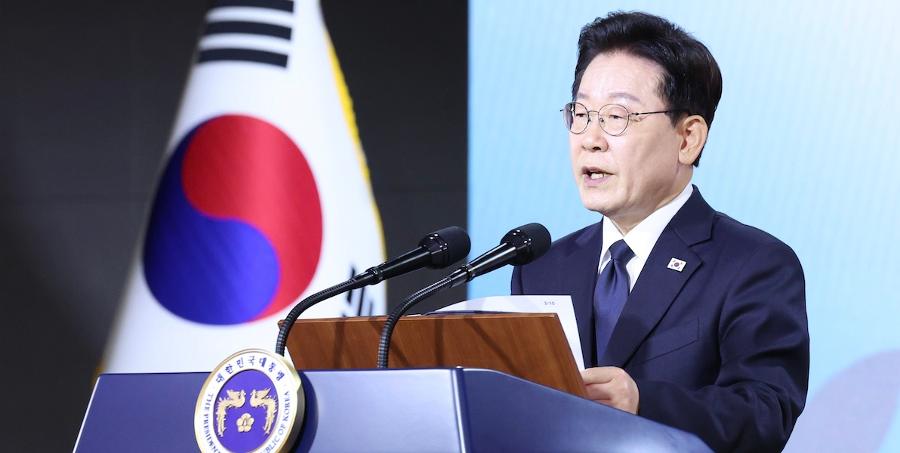 뉴스&이슈 이재명 개헌 포기하지 않았다 : 5월 무산 뒤에도 추진 의지, 부마항쟁 기념식서 울컥하며 "이제 행동할 때"
국회에 조속한 개헌 논의 촉구